Top 5 modeli AI według Artificial Analysis
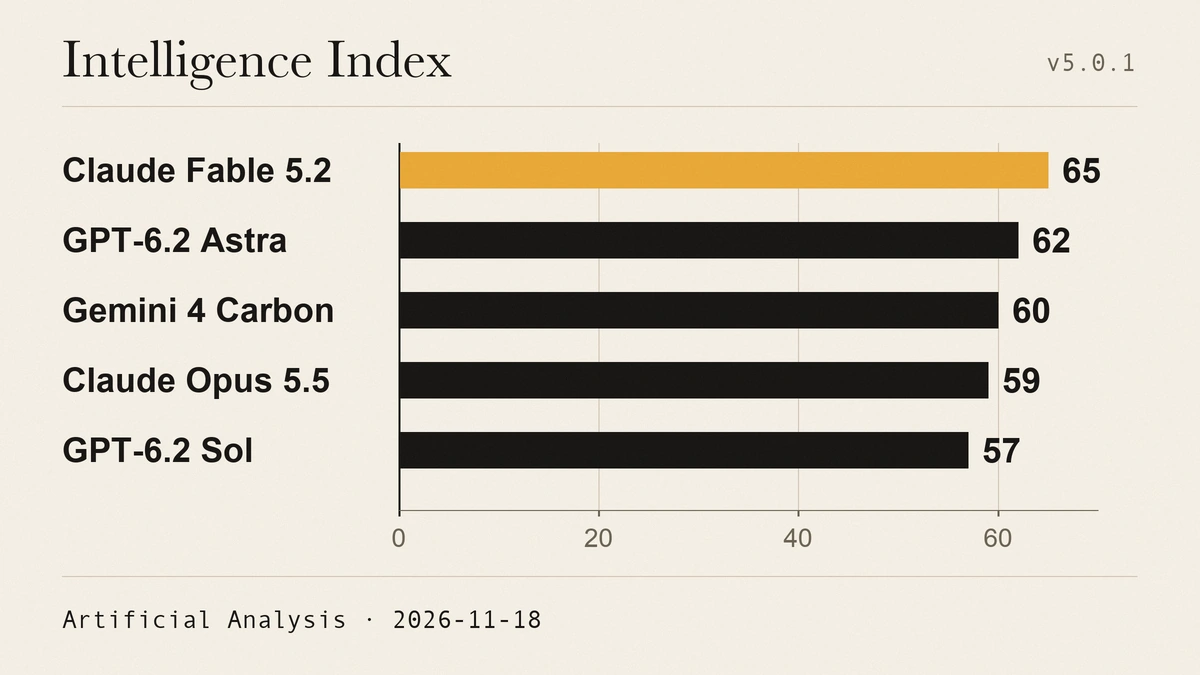
Porównujemy pięć najwyżej ocenionych odrębnych modeli w domyślnej tabeli Artificial Analysis, po jednej konfiguracji na model. Podajemy zaokrąglone punkty i poziom wysiłku obliczeniowego widoczne 18 listopada 2026 r. W pełnym zestawieniu kilka ustawień tego samego modelu może zajmować kolejne miejsca. Tabela wyników Artificial Analysis
- Claude Fable 5.2 — 65 pkt, Max z domyślnym przełączaniem na model zastępczy.
- GPT-6.2 Astra — 62 pkt, Max.
- Gemini 4 Carbon — 60 pkt, High.
- Claude Opus 5.5 — 59 pkt, Max z domyślnym przełączaniem na model zastępczy.
- GPT-6.2 Sol — 57 pkt, Max.
Dalej w tej samej tabeli Gemini 4 Hydrogen uzyskał 54 pkt przy ustawieniu Xhigh, a GPT-6.1 Terra 51 pkt przy ustawieniu Max. Indeks w wersji 5.0.1 łączy dziewięć testów. Po 25% wyniku przypada na pracę z informacjami i dokumentami, programowanie, naukę oraz wiedzę ogólną. Zadania są głównie tekstowe i anglojęzyczne. Jakość odpowiedzi na polską reklamację wymaga osobnej próby. Jak Artificial Analysis liczy indeks
OpenAI. Czym różnią się Astra, Sol i Terra?
GPT-6.2 Astra jest według OpenAI modelem do złożonych analiz i prac inżynierskich. Dobry test dla Astry to znalezienie rozbieżności między zapytaniem ofertowym, trzema załącznikami i arkuszem wyceny. GPT-6.2 Sol producent poleca do codziennej pracy, kodowania i powtarzalnych zadań wieloetapowych. Daj mu ten sam komplet danych, jeśli celem jest przygotowanie pierwszej wersji odpowiedzi według ustalonego wzoru. Przewodnik doboru modeli OpenAI
GPT-6.1 Terra warto sprawdzić tam, gdzie ważny szczegół widać na ekranie. Przykład z firmy handlowej to odczyt oznaczenia wariantu z karty produktu i przypisanie go do właściwego pola formularza. Wszystkie trzy modele są dostępne przez API OpenAI. Astra 6.2 i Sol 6.2 pojawiły się w nim 17 listopada 2026 r. Historia wydań API OpenAI
Claude Fable czy Claude Opus?
Anthropic zaleca Claude Opus 5.5 jako punkt wyjścia do codziennego programowania i pracy z dokumentami. Claude Fable 5.2 przeznacza do trudnych, otwartych problemów technicznych. Przy przenoszeniu starego kalkulatora wycen do aplikacji można zlecić Opusowi przygotowanie testów znanych rabatów. Fable warto dać przypadki, dla których dawny i nowy kalkulator zwracają różne kwoty, a reguły nie zostały spisane. Poproś o wskazanie reguły i przykład, na którym da się ją potwierdzić. Zalecenia Anthropic dla Opus i Fable
Fable 5.2 jest dostępny między innymi przez Claude Platform oraz w płatnych planach Claude, w tym Pro i Team. W teście integracji zapisuj nazwę użytego modelu, ustawienia i koszt wywołań. Dzięki temu po zmianie wersji będzie można odtworzyć porównanie. Dostępność Claude Fable

Do czego nadaje się Gemini 4 Hydrogen?
Google zaprojektował Gemini 4 Hydrogen z myślą o szybkim wykonywaniu zadań z użyciem narzędzi. W ofercie Google to Carbon i Argon są przeznaczone do dłuższych analiz. Hydrogen można wypróbować przez Gemini API lub Google AI Studio. Przykładowe zadanie dla działu sprzedaży to rozpoznanie języka zapytania, wybranie kategorii usługi i przygotowanie danych dla CRM. W bezpłatnej aplikacji Gemini system może dobrać Hydrogen automatycznie. Opis i dostępność Gemini 4 Hydrogen według Google
Jak wybrać model do obsługi zapytań klientów?
Weź 30 archiwalnych wiadomości po usunięciu danych osobowych. Wybierz 20 typowych zapytań i 10 wymagających dopytania albo przekazania człowiekowi. W tej drugiej grupie przydaje się e-mail z dwiema różnymi datami odbioru i taki, w którym numer detalu podano wyłącznie na niewyraźnym zdjęciu.
- Przed uruchomieniem testu handlowiec zapisuje poprawny numer detalu, termin i oczekiwany następny krok dla każdej wiadomości.
- Każdy model dostaje tę samą instrukcję, zestaw załączników i dostęp do tych samych narzędzi. Handlowiec ocenia odpowiedzi z ukrytymi nazwami modeli.
- Zapisz błędne obietnice terminu, liczbę odpowiedzi gotowych do wysłania, minuty poprawek i czas oczekiwania. Sprawdź osobno trudne przypadki.
- Policz koszt jednej zaakceptowanej odpowiedzi. Dodaj koszt wywołań modelu i czas sprawdzania przeliczony na złote, a sumę podziel przez liczbę zaakceptowanych odpowiedzi.
Jeśli szybszy model poprawnie obsługuje standardowe pytania, a trudne rozpoznaje i odsyła do handlowca, można zacząć od takiego podziału pracy. Drugi model warto włączyć tam, gdzie w próbie rzeczywiście rozwiązał problem. W KTBmatic raport lokalnej widoczności pokazuje przykład pracy, którą można rozłożyć na mniejsze, sprawdzalne etapy. Zobacz aplikację KTBmatic